„php2shell“, wie die Sicherheitslücken CVE-2026-109618 und CVE-2026-109619 auch genannt werden, war in den letzten Tagen allgegenwärtig. Kaum etwas hat die Sysadmin-Welt in den letzten Jahren so in Aufruhr versetzt, wie diese unscheinbare Lücke im PHP-Interpreter, der weltweit auf je nach Schätzung zwischen 20 und 40 Millionen Systemen zum Einsatz kommt. In diesem Artikel wollen wir kurz erzählen, was in Agentur-Providern wie Frachtwerk in solchen Momenten eigentlich passiert und was für uns am Ende eigentlich viel schlimmer als php2shell war…
Bei Frachtwerk sind wir für den Betrieb von ca. 1400 Docker-Containern in 350 Anwendungen verantwortlich. Die betreiben wir sowohl für uns, als auch für Kunden – das meiste davon sind Open-Source-Anwendungen, die wir zwar betreiben, aber nicht selbst entwickelt haben. Darunter natürlich einiges an PHP-Anwendungen, sodass php2shell große Auswirkungen auf uns hatte, ohne dass wir selbst aktiv in PHP entwickeln. Als Betreiber von u.a. KRITIS-Anwendungen haben wir teilweise hohe Service Level, die von unserer Rufbereitschaft und unserem Team Operations an 7 Tagen pro Woche fast rund um die Uhr gecheckt werden.
Was ist php2shell eigentlich?
Um die ganze Aufregung besser zu verstehen ein ganz kurzer Exkurs in die Welt von PHP, Interpretern und Exploits: Worum geht es hier eigentlich? PHP ist eine 1995 entwickelte Programmiersprache für Webanwendungen (der Name stand ursprünglich für „Personal Home Page Tools“). Die Besonderheit von PHP ist, dass der Code nicht kompiliert wird, sondern live beim Aufruf einer Website von einer Software – „Interpreter“ genannt – ausgeführt („interpretiert“) wird. Damit wird auch klar, wie eine Programmiersprache überhaupt angreifbar sein kann: Die Lücken in diesem Fall betreffen den Interpreter, nicht die Programmiersprache selbst.
Vereinfacht gesagt nimmt der Interpreter eine Anfrage z.B. eines Browsers entgegen, führt von der Festplatte des Servers den entsprechenden Code aus und schickt das Ergebnis an den Browser zurück (um genau zu sein ist als Software noch ein Webserver dazwischen, aber darum soll es nicht gehen). Was so banal klingt, ist in der Realität hochkomplex. Die beiden Sicherheitslücken setzen bei der Abwicklung der Anfrage an. Für jede Anfrage steht nur ein begrenztes Speichervolumen zur Verfügung (standardmäßig 128 MB). Wird dieses Limit erreicht, bricht der Interpreter die Anfrage ab und gibt den belegten Speicher wieder frei. Genau bei diesem Aufräumen liegt der Fehler hinter CVE-2026-109618: Unter bestimmten Umständen wird der Speicher dabei fehlerhaft verwaltet und nicht wieder komplett freigegeben. Ein Angreifer kann eine Anfrage gezielt so gestalten, dass sie dieses Limit erreicht, wodurch die Anfrage abgebrochen wird und die entstehende fehlerhafte Verwaltung über weitere Anfragen so ausnutzen, dass am Ende von ihm eingeschleuster Code auf dem Server ausgeführt wird.
Die zweite Lücke, CVE-2026-109619, nutzt aus, dass PHP auf Servern meist nicht für jede Anfrage komplett neu startet. Stattdessen arbeitet ein sogenannter Worker-Prozess viele Anfragen nacheinander ab und merkt sich dabei interne Zustände, etwa zu Fehlermeldungen oder Sessions. Einige davon verweisen während einer Anfrage auf Speicher, der nur zu dieser Anfrage gehört. Am Ende der Anfrage wird dieser Speicher freigegeben; der Verweis darauf müsste vorher zurückgesetzt werden. Durch bestimmte Fehlerkonstellationen bleibt er jedoch bestehen und der Interpreter verwendet nun Speicher, der bereits freigegeben ist. Übernimmt derselbe Worker die nächste Anfrage, verwendet PHP unter Umständen diesen eigentlich freigegebenen Speicherbereich. Gelingt es einem Angreifer, an dieser Stelle in der ersten Anfrage eigenen Code zu platzieren, kann er darüber den Interpreter dazu bringen, diesen Code auf dem Server auszuführen.
Dadurch, dass beide Lücken im Interpreter und nicht in individuellen PHP-Code angesiedelt sind, sind automatisch alle PHP-Systeme betroffen – völlig unabhängig vom jeweiligen Code oder Login-Status. Damit erhielten beide Lücken im sog. „CVSS-Rating“, der Bewertung von Sicherheitslücken jeweils das Rating 9,2 von 10 maximal möglichen Punkten, was in dieser Konstellation einem absoluten Desaster gleichkommt: Zwei Sicherheitslücken mit fast maximalem Schadenspotenzial, ca. 20 bis 40 Millionen potenzielle Ziele und keine Möglichkeit, Angriffe auf diese Lücken vollständig zu verhindern! Und die Möglichkeit, beliebige Server zu übernehmen, Daten zu kopieren oder Konten zu kompromittieren – ohne dass ein Admin etwas davon mitbekommt.
Warum wurden die Fehler nicht einfach behoben?
Die beiden Lücken waren den Entwicklern von PHP in abgewandelter Form bereits seit 2004 bekannt. Durch Zielkonflikte und gelähmte Strukturen zog sich die Behebung jedoch über zwei Jahrzehnte hin. Der stärkere Einsatz von KI sowohl in der Suche als auch im Ausnutzen von Schwachstellen führte dazu, dass die gleichen Lücken 2020, 2024 und 2026 jeweils nochmal an das PHP-Team gemeldet wurden. Damit wandelte sich die Betrachtung der Lücken von einem anfangs eher theoretischen Konstrukt spätestens im August 2026 durch die Meldung seitens OpenAI zu einer konkreten Bedrohung. Damit wurde eine zeitnahe Behebung unumgänglich und führte zum bislang größten Fix in der Geschichte von PHP: Bedingt durch die Komplexität des Speichermanagements umfasste die Behebung (ein sog. „Patch“) über 11.000 Zeilen Code und betraf 423 Dateien.
12.10.2026 – das Embargo
Damit beginn ein echter Krimi: Das PHP-Team erkennt die unheimliche Tragweite dieser Sicherheitslücken und unterrichtet Sicherheitsbehörden, KRITIS und große Infrastrukturbetreiber über die Lücken. Über KRITIS-Kunden von Frachtwerk erfahren Kollegen von uns am 19.10. das erste Mal von den Lücken – allerdings noch zu vage, um irgendwelche Schlüsse daraus zu ziehen. Ansonsten sieht der Rest der Welt nur, dass zwei Nummern für Sicherheitslücken – CVE-2026-109618 und CVE-2026-109619 reserviert wurden. Was sich dahinter verbirgt, weiß noch fast niemand. Den beteiligten Partnern wird seitens PHP-Team der 22.10.2026 18:00 MESZ als Embargo-Termin genannt, bis zu dem keine Information veröffentlicht werden darf. Denn sobald Informationen zu den Lücken öffentlich würden, könnten Angreifer mittels KI gezielt danach suchen und Schadsoftware (sog. „Exploits“) entwickeln, um genau diese Lücken auszunutzen.
20.10.2026 – eine erste Notiz
Am Dienstag 20.10. haben mein Kollege Tobi und ich unser reguläres Weekly. Er macht mich auf einen Post in einer Matrix-Gruppe einiger CCC-Admins aufmerksam, in der gemunkelt wird, es gäbe zwei Lücken in PHP mit dem maximalen CVS-Score von 10.0. Am späten Nachmittag treffen wir auch auf eine ganz frische Nachricht des Users „petecooper“ in einem Forum des ycombinator vom gleichen Tag 15:20 Uhr:
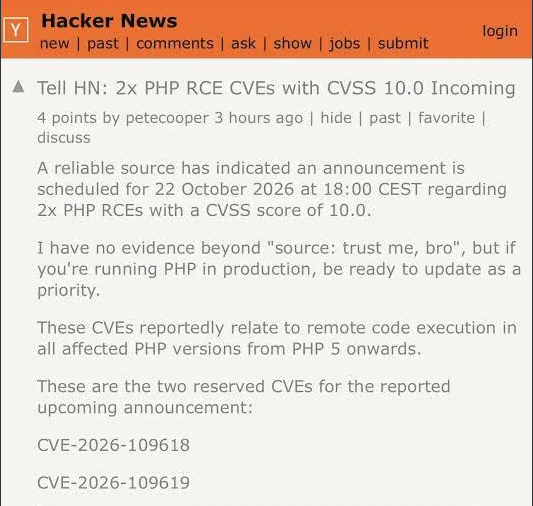
Damit wird langsam klar: Das Embargo hat einen Riss, mindestens eine Partei hat offenbar Informationen in die Öffentlichkeit durchsickern lassen – wie sich später herausstellt, nicht das einzige Mal.
Bei Frachtwerk bringt uns diese Nachricht einen hilfreichen Vorteil: Wir können schonmal prüfen, wie viele PHP-Anwendungen wir eigentlich betreiben und auf welchen Versionen diese laufen. Das Ergebnis: über 120 Anwendungen – darunter auch ein paar, die definitiv nicht mehr updatefähig sein werden, da sie zu alt sind. Also nutzen wir den Abend spontan dazu, diese Altanwendungen auf einen Stand zu bringen, auf dem wir hoffentlich noch ein PHP-Update einspielen können.
Technischer Kommentar: Wie kommen wir bei 1.400 Containern am schnellsten an alle Container mit PHP-Versionen? Über ein Ansible-Playbook, das wir in AWX ausführen, das auf allen unseren Servern in jeweils allen dort laufenden Containern prüft, welche PHP-Version dort läuft. Ein reines Überprüfen der genutzten Images ist nicht ausreichend, denn nur in den wenigsten Fällen wird ein Dienst direkt auf einem PHP-Base-Image aufgebaut! Die betroffenen Container sammeln wir mit Server- und Containername sowie Version in einem geteilten Dokument, um dort gemeinsam den Status der Behandlung tracken zu können. Würde zugegebenermaßen etwas eleganter auch per Software gehen, aber dafür kommt das – noch – zu selten vor.
Abends kommt eine offizielle Meldung von PHP, dass die Veröffentlichung der Fixes auf den nächsten Tag gelegt wird:
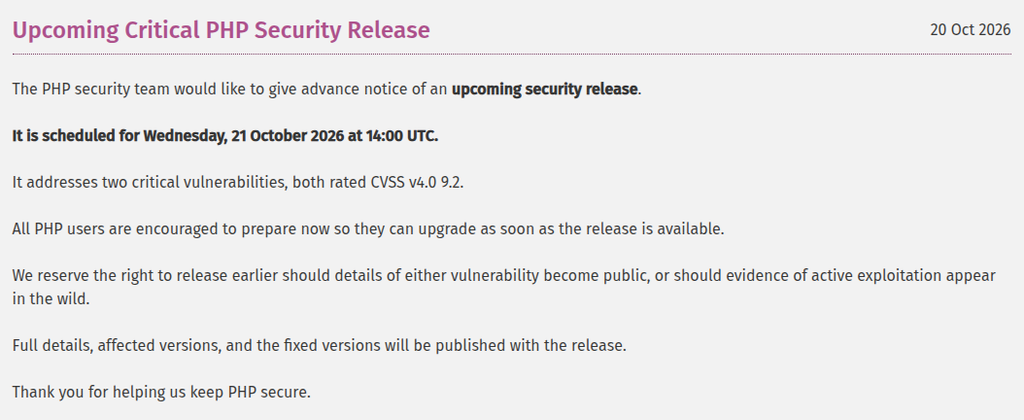
Damit wurde die Veröffentlichung offenbar um einen Tag vorgezogen und der inoffizielle Embargo-Termin ist wohl hinfällig. Es ist echt wild zu sehen, wie nervös die Admin-Welt ist, aber das geht uns ja nicht anders. Die am kritischsten betroffenen Kunden bekommen von uns eine Vorabinfo per Mail, was passiert ist und passieren könnte – inkl. der Info, dass ggf. abgeschaltet werden muss.
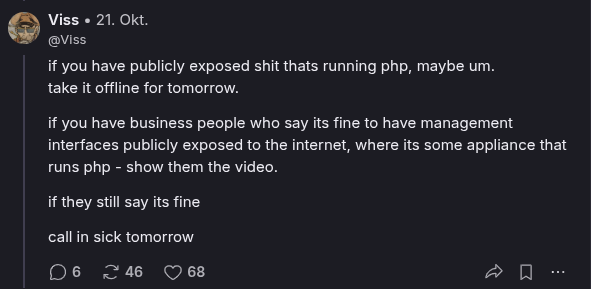
21.10.2026 05:39 Uhr – der Super-GAU
Am nächsten Morgen bekomme ich von einem befreundeten Admin um 05:39 Uhr den Hinweis geschickt, dass durchgesickert ist, was die Lücke verursacht hat und aber auch einen Link zu einem Exploit, mit dem sich die Lücke höchstwahrscheinlich ausnutzen lässt. Immerhin ist dadurch auch ein bisschen mehr darüber bekannt, wie sich die Lücken verhindern lassen, aber eine wirkliche Sicherheit dazu gibt es nicht. Offenbar lassen sie sich immerhin teilweise verhindern:
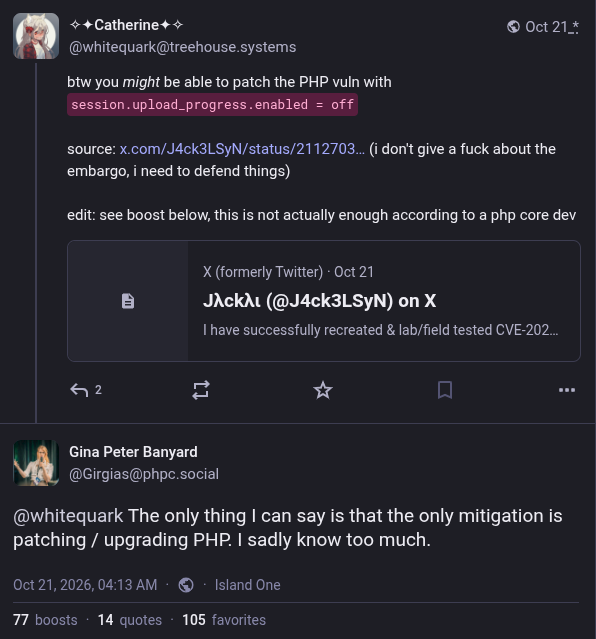
Was macht man als Betreiber in so einem Moment? Komplett offline nehmen ist bei Systemen, die nicht länger als 120 Minuten offline sein dürfen keine wirkliche Option, also entscheiden wir uns für einen hybriden Ansatz:
- so viel wie möglich am zentralen Proxy filtern, wohlwissend, dass das kein hundertprozentiger Schutz ist
- Anwendungen, die nicht öffentlich sein müssen, mit einem Passwortschutz mittels
basic authversehen, was definitiv schützt - was nicht notwendig ist abschalten
Bis 8 Uhr informieren wir die wichtigsten Kunden telefonisch über das Vorgehen und schalten den offline genommenen Anwendungen eine hübsche Informationsseite vor, um über den Umstand zu informieren.
Ungefähr zur gleichen Zeit veröffentlicht Chainguard, ein Hersteller gehärteter Container bereits die verteilten Fixes für PHP – mehr als sechs Stunden vor der vereinbarten Zeit. Damit ist endgültig klar, dass nun jeder, der sich die Änderungen in dieser Veröffentlichung anschaut auf die ursprüngliche Lücke schließen – und diese ausnutzen kann.
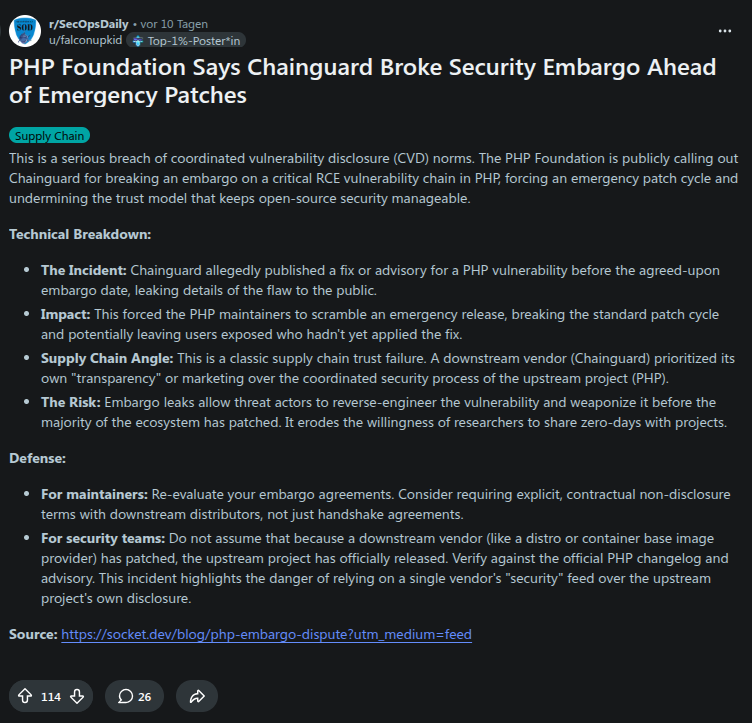
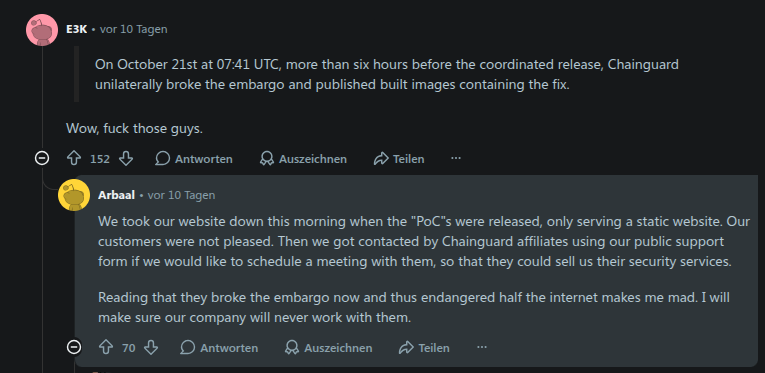
Um 11:50 Uhr kommt dann auch die Warnung vom BSI an Betreiber rein – ein wenig spät, aber immerhin!
Technischer Kommentar: Wie hält man als Betreiber den Überblick über Kunden bei 350 Systemen? Wir verwalten alle Systeme in LDAP – dort ist direkt als Attribut der jeweilige Kunde hinterlegt. Zur Kommunikation nutzen wir Zammad, ein ziemlich cooles Support-Tool. Dort haben wir für bestimmte Incidents auch gleich Templates hinterlegt, um sich im Ernstfall nicht erst Empfänger und Texte ausdenken zu müssen.
21.10.2026 16:00 Uhr – endloses Warten
Punkt 16 Uhr steht fast das ganze Team bereit, um Updates einspielen zu können. Das funktioniert in vielen Fällen zwar automatisch, sobald neue Versionen für Container bereitstehen – bei selbst gebauter Software müssen aber sog. „Pipelines“ neu ausgelöst und bei Software von Drittanbietern manuell geprüft werden, ob überhaupt Updates zur Verfügung gestellt werden.
Und es passiert: nichts.
Zumindest nicht viel – um 15:43 Uhr gibt es einen Hinweis seitens PHP auf Veröffentlichungen, aber unsere Erwartung, dass entsprechend der langen Vorbereitungszeit um 16 Uhr fertige Images zur Verfügung stehen erfüllt sich nicht. Nachdem auch um 16:30 Uhr noch keine Updates zur Verfügung stehen, entscheiden wir uns für’s Abschalten. Also stoppen wir alle 120 Anwendungen, die wir bereitstellen sowie noch ca. 30 weitere, die wir in Vereinen betreiben. Damit sind wir auch nicht alleine – überall auf der Welt nehmen Betreiber ihre PHP-Anwendungen offline – nicht ohne Grund: Das Ausnutzen der Sicherheitslücken lässt sich recht gut in Logfiles nachvollziehen, da – wie oben beschrieben – ja mehrere präparierte Anfragen nacheinander an einen Server geschickt werden müssen. Diverse Betreiber stellen ziemlich schnell nach der angekündigten Veröffentlichung erste Angriffe fest:
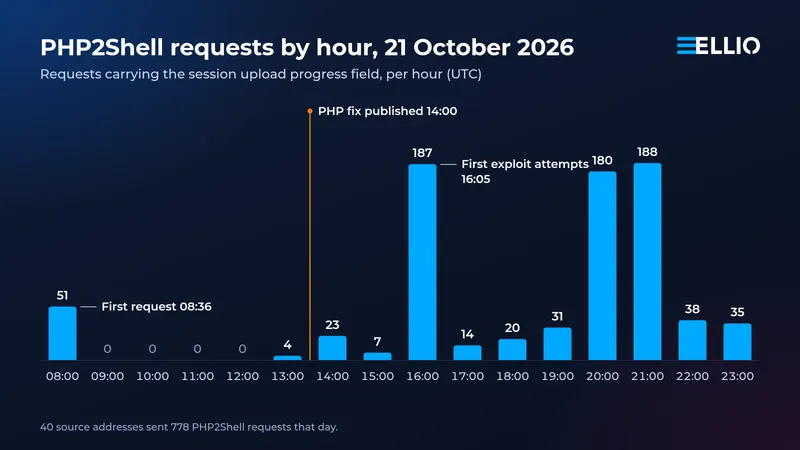
Wir stellen keine derartigen Anfragen fest – aber sicher ist sicher.
Technischer Kommentar: Aus den Ergebnissen des o.g. Playbooks lassen sich per Script einfach ssh-Befehle bauen, die auf allen Servern jeweils die Container mit installierter PHP-Runtime abschalten. Beim Abschalten nicht vergessen, zusätzlich auch die Restart-Policy zu deaktivieren!
21.10.2026 18:59 Uhr – die Post ist da!
Drei Stunden später ist es dann endlich soweit: Es gibt endlich veröffentlichte „Images“, die wir einspielen können!
Und was passiert? Natürlich sind alle Server, die Updates bereitstellen überlastet:
Der Rest geht aber recht geräuschlos vonstatten. Im Laufe des Abends werden überall Updates eingespielt und um 01:09 Uhr werden die letzten Systeme wieder als up and running gemeldet.
Technischer Kommentar: Wir verwenden überall Watchtower, das uns Container bei Updates automatisch aktualisiert. Bei allen eigenen Anwendungen muss die CI/CD-Pipeline in Gitlab manuell angestoßen werden (und dabei ggf. gepinnte Versionen hochgezogen werden). Um schneller fertig zu werden, haben wir die Server auf alle beteiligten Kolleg:innen aufgeteilt. Anbieter wie WordPress, HumHub usw. müssen erstmal selbst aus den Quellen ihre Images bauen – die bleiben im Zweifel dann halt abgeschaltet.
23.10.2026 – und es geht schon wieder los!
Wir müssen uns vermutlich an ein neues Zeitalter gewöhnen, denn keine zwei Tage nach der PHP-Lücke geht es gerade mit Node.js weiter:
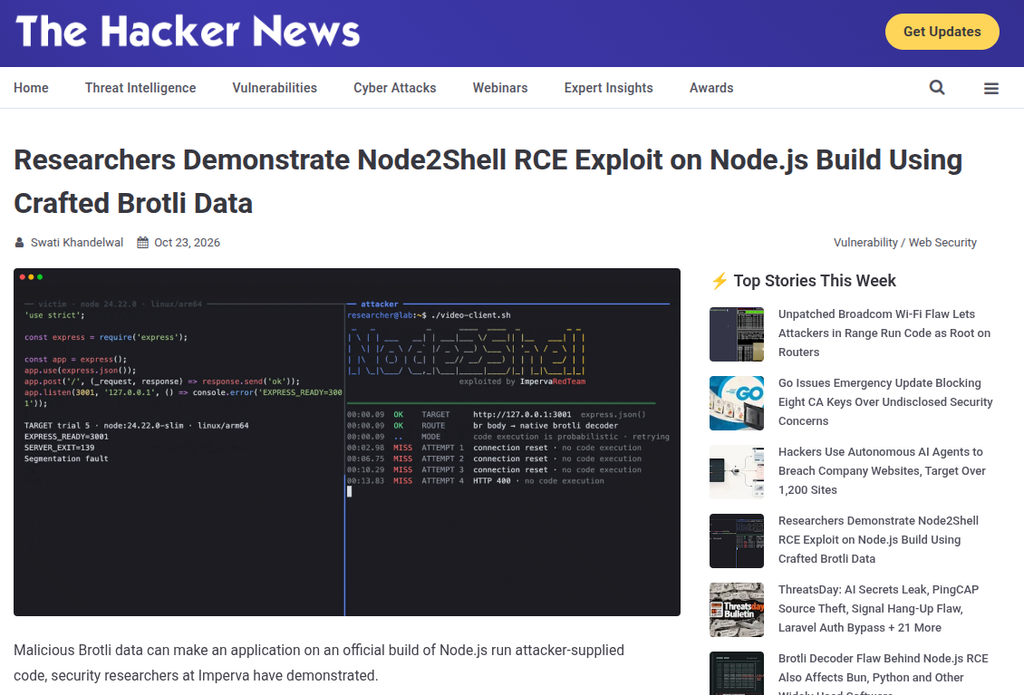
Eine ziemlich ähnliche Lücke in „Brotli“, einem Kompressionsalgorithmus für HTTP-Anfragen in Node.js. Zum Glück sind die Tools ja noch warm, also alles von vorn:
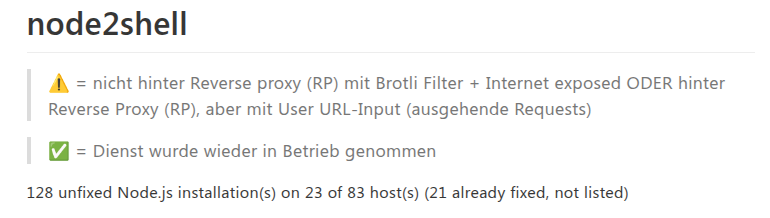
128 ungepatchte Systeme möchten aktualisiert werden. Da es hier deutlich schwieriger ist, herauszufinden, welche Systeme betroffen sind und bereits Exploits im Umlauf sind, die diese Lücke ausnutzen, entscheiden wir uns auch hier wieder zum großflächigen Abschalten. Wie’s weiterging, erfahrt ihr vllt. im nächsten Blogbeitrag… 😉
Technischer Kommentar: Bei PHP war es recht einfach, die PHP-Version zu prüfen und zu wissen, ob ein komplettes System betroffen ist oder nicht. Das hat es für uns als Betreiber auch noch gut automatisierbar gemacht. Bei Brotli klappt das nicht – es ist zwar möglich, die Node.js-Version abzufragen, das sagt aber nichts darüber aus, ob Brotli tatsächlich verwendet wird. Zusätzlich sind Systeme über eingehende und ausgehende Verbindungen verwundbar. Eingehende Verbindungen können wir wieder einfach zentral am Proxy mitigieren – ausgehende Verbindungen nutzen keinen Proxy und sind zudem direkt ab Container SSL-verschlüsselt. Also entscheiden wir uns lieber großflächig für Abschalten, nehmen System für System eine Prüfung vor, im Zweifel mittels KI auf Quellcodeebene und schalten erst wieder frei, wenn wir uns halbwegs sicher sind, dass beide Richtungen gepatched sind.
Was lernen wir daraus?
Einiges. Erstens: Durch KI werden deutlich mehr Sicherheitslücken gefunden, gleichzeitig werden sie viel schneller ausgenutzt. Großflächige Angriffe auf Sicherheitslücken 2-3 Stunden nach Veröffentlichungen waren früher eher die Ausnahme – heute wird es offenbar die Regel. Als Betreiber wird es also umso wichtiger, schnell am Ball zu sein. Dass drei Tage später immer noch große Teile des Internets nicht aktualisiert ist, ist wenig hilfreich:
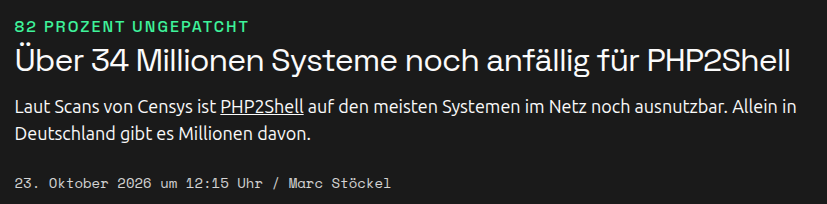
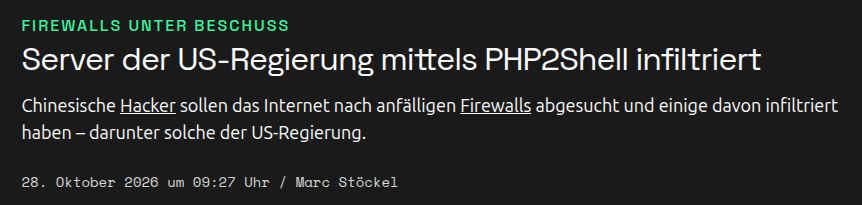
Und so ist wenig verwunderlich, dass selbst Server der US-Regierung mittels php2shell infiltriert werden. Man könnte ja meinen, der ganze Stress wäre halb so wild, denn genau dafür ist Docker ja u.a. da – den ggf. erfolgreichen Angriff auf einen Container zu beschränken – tatsächlich werden in diesem Exploit zwei Sicherheitslücken kombiniert: php2shell, um einen Container anzugreifen und ein Kernel-Exploit, um aus dem Container auszubrechen und root-Rechte auf dem Host-System zu erlangen:
Zweitens: In der heutigen Geschwindigkeit ist ein koordiniertes Vorgehen super wichtig. PHP hat hier einen ziemlich guten Job gemacht und die Veröffentlichung lange vorbereitet und bis zuletzt gut unter Verschluss gehalten. Über das Versagen von Chainguard wurden im Internet schon genug Worte verloren – aber fast genauso schlecht performed haben die viele große Plattformen: Dass die neuen Images erst drei Stunden später auf Docker Hub zur Verfügung standen, weil man dort auf einem Regelprozess bestand, während das halbe Internet brannte, ist nicht so wirklich nachvollziehbar. Warum hat man damit nicht schon früher begonnen? Ähnliches bei den Distributionen: Einige haben einen ziemlich guten Job gemacht – aber auch bei Red Hat z.B. hat die Veröffentlichung mehrere Stunden gedauert.
Was heißt das für uns als Betreiber?
Bezogen auf php2shell sind wir ganz zufrieden, dass wir frühzeitig Bescheid wussten und rechtzeitig handeln konnten. Das heißt aber auch, dass wir permanent prüfen müssen, welche Auswirkung welche CVEs auf uns haben könnten. Offizielle Infos sind dabei häufig zu langsam, d.h. Quellen wir Matrix-Gruppen helfen häufig tatsächlich mehr. Die beiden Beispiele hier zeigen aber auch, dass zwischen Warnung und Angriffen dank KI mittlerweile häufig nur noch Stunden liegen. Das wird für unsere Rufbereitschaft und unser Team Operations zukünftig noch viel relevanter.
Bzgl. der Abarbeitung haben wir gemerkt, dass eine Bearbeitung der Informationen per Hedgedoc zwar funktioniert und sehr leichtgewichtig ist – bei der steigenden Häufigkeit wäre ein zentrales System, das alle Infos (welches Event, welche Container sind betroffen, welche Versionen laufen dort, sind die Container online oder offline, Notizen zu den Containern bzw. Einschätzungen zur Betroffenheit, Zuordnung zu Personen aus dem Team Operations, …) zusammenzieht und automatisch aktualisiert sehr hilfreich. Mal schauen, was das nächste Event so mit sich bringt…
